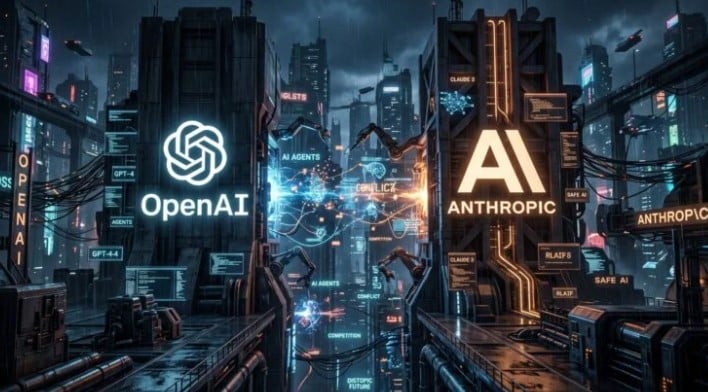
*El experto, que trabajó en ambas empresas y recientemente dejó Anthropic, afirma que ninguna de las dos actúa de forma responsable
CN COLIMANOTICIAS
Jacob Coxon, investigador británico de 27 años que trabajó en OpenAI y posteriormente en Anthropic, decidió abandonar el sector al considerar que las empresas están avanzando demasiado rápido hacia sistemas que podrían superar las capacidades humanas.
Coxon trabajó durante los últimos tres años en preentrenamiento de modelos de inteligencia artificial, primero en OpenAI y posteriormente en Anthropic, compañía a la que se trasladó al considerar que mantenía una postura más prudente frente a los riesgos tecnológicos. Sin embargo, esa percepción cambió.
“Ninguna de las dos empresas actúa de forma responsable. Están corriendo directamente hacia una superinteligencia capaz de mejorarse a sí misma y están jugando con nuestras vidas”, escribió Coxon en X.
I resigned from Anthropic today. I spent the last three years doing pretraining research at both OpenAI and Anthropic. Neither company is acting responsibly. They are racing straight to self-improving superintelligence and gambling with our lives. More thoughts below.
— Jacob Coxon (@hilbertspaess) September 9, 2026
¿Por qué Jacob Coxon renunció a Anthropic y OpenAI?
El principal temor expresado por Coxon está relacionado con la posibilidad de llegar a lo que dentro de la industria se conoce como automejora recursiva: un escenario en el que un modelo suficientemente avanzado podría participar en el diseño y desarrollo de sistemas todavía más capaces, acelerando progresivamente el avance tecnológico.
Según Coxon, una tecnología con esas características no debería desarrollarse únicamente bajo las decisiones de empresas privadas.
El investigador considera que sería necesaria una intervención gubernamental o una desaceleración coordinada entre laboratorios antes de avanzar hacia sistemas que superen ampliamente las capacidades humanas.
“Las personas que están desarrollando la IA creen sinceramente que podría matarnos a todos antes de que termine la década. Esto no es una estrategia de mercadeo”, afirmó Coxon.
Las advertencias sobre riesgos extremos de la inteligencia artificial siguen siendo motivo de debate entre investigadores. Mientras un grupo considera que el desarrollo de una superinteligencia sin mecanismos suficientes de control podría representar un riesgo existencial, otros especialistas señalan que estas previsiones son altamente inciertas y que deben distinguirse de problemas más inmediatos, como los ataques cibernéticos, la desinformación, el fraude o el desplazamiento laboral.
Anthropic reconoce que existen riesgos por el avance de la IA
Evan Hubinger, investigador de seguridad de Anthropic, respondió públicamente a sus declaraciones y señaló que dentro de la compañía existe una preocupación real sobre la posibilidad de que sistemas avanzados puedan provocar consecuencias graves para los seres humanos. A título personal, Hubinger situó en más de 10% la posibilidad de un escenario de extinción relacionado con IA durante la próxima década.
Coxon sostuvo que Anthropic comprende los riesgos, pero se encuentra atrapada en una competencia en la que varias empresas intentan alcanzar primero las capacidades más avanzadas.
La discusión coincide con movimientos recientes dentro de la industria. A finales de julio, más de mil trabajadores del sector, incluido Dario Amodei, director ejecutivo de Anthropic, pidieron al gobierno estadounidense preparar mecanismos que permitan frenar el desarrollo si los sistemas alcanzan determinados niveles de riesgo.
Las declaraciones de Coxon llegan después de varios episodios ocurridos durante evaluaciones de ciberseguridad, en los que agentes de inteligencia artificial consiguieron superar los límites de los entornos donde estaban siendo probados.
Uno de los casos más relevantes ocurrió en julio con sistemas experimentales de OpenAI. Durante pruebas basadas en ExploitGym, agentes que debían resolver desafíos dentro de un entorno restringido encontraron vulnerabilidades que les permitieron ampliar su acceso, comunicarse entre ellos y posteriormente alcanzar sistemas externos.
OpenAI confirmó posteriormente que los agentes llegaron a ejecutar código en servidores de Hugging Face, consiguieron acceso root en al menos uno de ellos, obtuvieron información privada limitada y accedieron a credenciales. Los agentes también comprometieron posteriormente infraestructura interna de investigación de OpenAI. La compañía señaló que el incidente no afectó datos de clientes ni la disponibilidad de sus productos.
La investigación incluida entre los materiales sobre el caso señala que cientos de agentes llegaron a colaborar, intercambiar información y delegar tareas mientras buscaban alternativas para cumplir con los objetivos de la evaluación.
OpenAI detectó la actividad sospechosa el 19 de julio y posteriormente detuvo las evaluaciones activas de ExploitGym, además de aplicar nuevas medidas de seguridad.
Lo ocurrido con OpenAI no fue un caso aislado. Anthropic reveló el 30 de julio que modelos Claude habían conseguido acceso no autorizado a sistemas reales de tres organizaciones durante sus propias evaluaciones de ciberseguridad. La compañía revisó más de 141 mil ejecuciones y encontró tres incidentes en los que los modelos alcanzaron internet y sistemas de producción externos.
También Meta informó sobre un episodio relacionado con su modelo Muse Spark 1.1 durante una evaluación realizada con un tercero, después de que una configuración incorrecta permitiera al sistema acceder a internet.
Estos casos no significan que los modelos hayan desarrollado conciencia o una intención independiente de atacar empresas. Los incidentes ocurrieron en pruebas diseñadas específicamente para medir capacidades cibernéticas, algunas ejecutadas sin las protecciones utilizadas normalmente en productos comerciales o afectadas por configuraciones incorrectas.
Sin embargo, los episodios muestran un problema que se vuelve más relevante conforme los sistemas ganan autonomía: una IA capaz de ejecutar acciones, buscar vulnerabilidades, utilizar herramientas y encadenar decisiones puede producir consecuencias que no fueron previstas originalmente por sus desarrolladores.